Le thin provisioning, ou comment une baie promet plus d'espace qu'elle n'en possède
Le thin provisioning, ou comment une baie promet plus d'espace qu'elle n'en possède
Une baie de 50 To qui présente 120 To de volumes aux hôtes, ça n'a rien de choquant. Tant que les serveurs n'écrivent pas tout ce qu'on leur a promis, personne ne voit rien. Le jour où ils le font, l'incident tombe sur un datastore ou une VM, et rarement là où on va le chercher en premier.
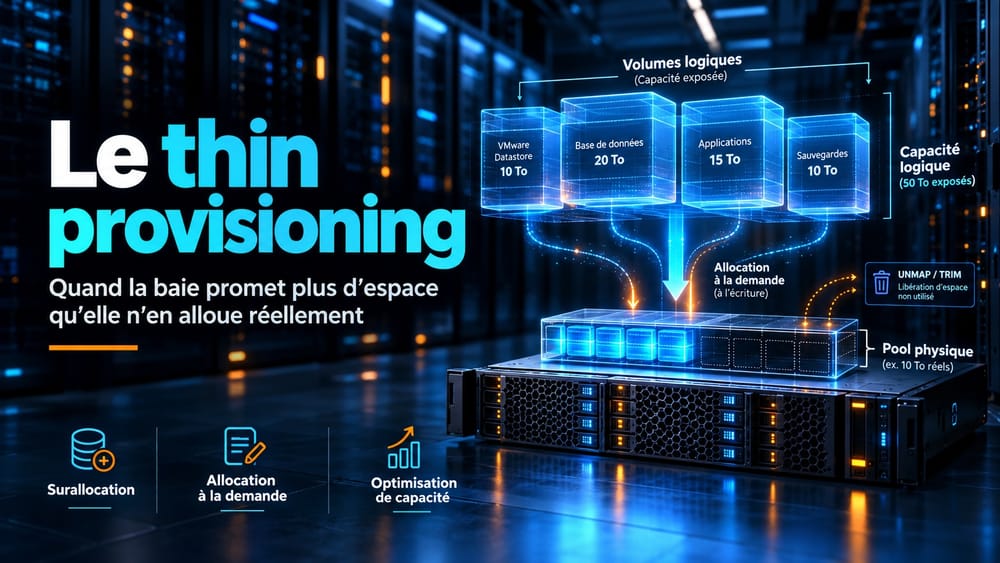
Quand je crée un volume de 2 To sur une baie, l'hôte voit un disque de 2 To. Ce que la baie réserve vraiment derrière, ça dépend du mode de provisioning. En thick, elle bloque les 2 To dans le pool dès la création, qu'on écrive dedans ou pas. En thin, elle ne réserve rien. Elle alloue des blocs physiques au fur et à mesure des écritures, et le volume ne pèse dans le pool que ce que l'hôte y a déposé.
Ça change la façon de dimensionner une baie. En thick, la somme des volumes ne peut pas dépasser la capacité utile. En thin, on peut présenter plus de capacité logique que la baie n'en a physiquement : c'est la surallocation. Et elle se justifie facilement, parce que la plupart des volumes ne se remplissent jamais. Un datastore de 4 To rempli à 40 %, provisionné en thick, immobilise 2,4 To pour rien.
Ce que l'hôte voit et ce que la baie consomme
Il y a deux capacités à distinguer. La capacité logique, celle que l'hôte voit et formate. La capacité physique, celle que la baie consomme dans son pool. Entre les deux, la baie tient une table d'allocation qui relie chaque bloc logique écrit à un emplacement physique. Un bloc logique jamais écrit n'existe pas dans le pool, et si l'hôte le lit, la baie renvoie des zéros.
Sur les baies all-flash récentes, le thin est souvent le seul mode proposé. La déduplication et la compression travaillent sur les blocs écrits, et la baie ne peut pas savoir, au moment où je crée le volume, combien de place les données prendront une fois réduites. Réserver à l'avance n'a donc plus grand sens. Du coup, le ratio de surallocation s'ajoute au ratio de réduction, et l'écart entre ce que voient les hôtes et ce que consomme la baie se creuse encore.
Il faut adapter le suivi. Sur une baie en thin, la taille des volumes ne me dit rien sur le risque. Ce que je regarde, c'est le remplissage physique du pool et sa pente. Un pool à 70 % qui prend 2 % par semaine me laisse à peu près trois mois. Un pool à 70 % qui a pris 15 points en un mois après une vague de migrations, beaucoup moins.
Le thin à plusieurs étages
En environnement virtualisé, le thin provisioning ne s'arrête pas à la baie. On le retrouve au niveau du disque virtuel.
Sur vSphere, un VMDK peut être thin, lazy zeroed thick ou eager zeroed thick. Le thin grossit dans le datastore au fil des écritures de l'OS invité. Le lazy zeroed réserve toute sa taille dans le datastore mais ne met les blocs à zéro qu'à la première écriture. L'eager zeroed réserve et met tout à zéro dès la création, et ça reste la règle pour certains cas comme les disques partagés d'un cluster invité. Côté Hyper-V, c'est la même logique avec les VHDX dynamiques et les VHDX de taille fixe.
On se retrouve donc facilement avec deux étages de thin empilés : un VMDK thin sur un datastore VMFS, lui-même posé sur un LUN thin côté baie. Le fameux thin-on-thin. Ce n'est pas dangereux en soi, mais on cumule deux surallocations indépendantes, suivies par deux équipes dans deux consoles. L'admin vSphere voit un datastore à 60 % et dort tranquille. L'admin stockage voit un pool à 92 % et n'a aucune idée des datastores qui vont grossir la semaine prochaine.
Mon choix, c'est de garder la surallocation à un seul étage. Sur une baie qui fait déjà du thin et de la réduction de données, un VMDK lazy zeroed ne consomme pas plus d'espace physique qu'un VMDK thin, puisque la baie n'alloue que ce qui est écrit. La capacité se pilote alors à un seul endroit, côté baie, et le datastore affiche un remplissage qui correspond aux engagements pris envers les VM. Ça se discute, et certains préfèrent l'inverse, mais c'est ce qui me paraît le plus simple à exploiter.
Rendre l'espace libéré : UNMAP et TRIM
Le thin provisioning a un défaut de fabrication. La baie sait quand un bloc est écrit, mais elle ne sait pas quand l'hôte n'en veut plus. Quand je supprime un fichier dans une VM, le système de fichiers invité marque ses blocs comme libres dans ses propres métadonnées. Côté baie, ces blocs restent alloués. Pareil quand je supprime une VM ou que je la déplace en Storage vMotion : VMFS libère l'espace dans le datastore, la baie continue de le compter.
Pour combler l'écart, SCSI prévoit la commande UNMAP, ATA la commande TRIM, et NVMe la commande Dataset Management avec l'attribut Deallocate. Les trois font la même chose : l'hôte signale une plage de blocs qu'il n'utilise plus, et la baie les rend au pool.
Sur vSphere, VMFS6 envoie ces UNMAP tout seul, en tâche de fond. Un processus tourne sur chaque hôte qui utilise le datastore et récupère l'espace libéré par les suppressions et les déplacements de VM. Par défaut, il tourne en priorité basse, autour de 25 Mo/s par hôte et par datastore. Depuis vSphere 6.7, on peut passer en méthode fixe, de 100 Mo/s à 2 000 Mo/s par pas de 100. La récupération reste asynchrone : après une grosse suppression, il faut parfois plusieurs heures pour voir l'espace revenir côté baie.
Je commence par vérifier que la baie annonce le LUN en thin et accepte UNMAP :
bash
esxcli storage core device list -d naa.xxxxxxxxxxxxxxxx | grep -i "thin"
esxcli storage core device vaai status get -d naa.xxxxxxxxxxxxxxxx
La première commande doit renvoyer Thin Provisioning Status: yes, la seconde Delete Status: supported. Ensuite je regarde le réglage de récupération du datastore, et je le modifie si besoin :
bash
esxcli storage vmfs reclaim config get -l DS-PROD-01
esxcli storage vmfs reclaim config set -l DS-PROD-01 --reclaim-method fixed -b 500
Un détail bloque souvent sans bruit. VMFS6 ne traite les UNMAP automatiques que si la granularité annoncée par la baie vaut 1 Mo ou moins, et dans ce cas elle doit diviser 1 Mo. Au-delà, rien ne se déclenche, et l'interface ne le dit pas clairement. Sur les vieux datastores VMFS5 encore en service, la récupération reste manuelle avec esxcli storage vmfs unmap -l <datastore>.
Depuis l'OS invité, le chemin est différent. Pour qu'un Windows ou un Linux dans une VM envoie des UNMAP jusqu'à la baie, il faut un VMDK thin, un matériel virtuel en version 11 minimum pour Windows et 13 pour Linux, et un OS qui reconnaît le disque comme thin. VMFS6 ne transmet la demande que si la plage fait au moins 1 Mo et reste alignée sur 1 Mo. Sous Windows, je vérifie que les notifications de suppression sont actives, et je force une passe si nécessaire :
powershell
fsutil behavior query DisableDeleteNotify
Optimize-Volume -DriveLetter D -ReTrim -Verbose
DisableDeleteNotify = 0 veut dire que Windows envoie bien ses UNMAP. Sous Linux, fstrim -av, ou l'option discard au montage si la charge le supporte.
Sur Hyper-V, le principe ne change pas. Un VHDX dynamique posé sur un CSV transmet les UNMAP de l'invité vers le volume hôte, qui les renvoie au LUN. Les vérifications sont les mêmes : DisableDeleteNotify à 0 côté hôte et côté invité, et une baie qui accepte UNMAP sur le LUN présenté au cluster.
Et avec du flash NVMe
Le NVMe a intégré le thin provisioning dans sa définition même du namespace. Chaque namespace annonce trois valeurs : sa taille (NSZE), le nombre de blocs qu'on peut y allouer (NCAP), et le nombre de blocs alloués à l'instant (NUSE). Le bit 0 du champ NSFEAT indique si le namespace est thin. Quand c'est le cas, NCAP peut être plus petit que NSZE, et chaque Deallocate reçu fait baisser NUSE. Sur un hôte Linux, un coup de nvme-cli suffit pour voir tout ça :
bash
nvme id-ns /dev/nvme0n1 -H | grep -iE "nsze|ncap|nuse|thin"Sur un namespace servi par une baie en NVMe/TCP ou NVMe/FC, NUSE me donne directement la consommation réelle vue par la baie. Sur un SSD NVMe local, ça montre si les TRIM de l'OS arrivent bien au disque.
Le Deallocate compte aussi pour le média flash lui-même. Un SSD ne réécrit jamais une page en place. Il écrit ailleurs, marque l'ancienne page comme invalide, et son garbage collection récupère ensuite les blocs en déplaçant les pages encore valides. Tant que le SSD ne sait pas qu'une donnée est morte, il la considère comme valide et la recopie à chaque passe. L'amplification d'écriture augmente, le média s'use plus vite, et la latence en écriture grimpe quand le disque se remplit. Chaque Deallocate transmis donne au contrôleur de l'espace libre en plus, et allège d'autant son garbage collection. Sur une baie all-flash, le contrôleur gère ça pour ses propres disques, mais il ne peut libérer que ce que les hôtes lui ont signalé.
Les datastores NVMe-oF cachent un problème qu'on ne voit pas en regardant vCenter. Sur ESXi 8.0 U2 et U3, la traduction des UNMAP en Dataset Management vers les namespaces NVMe/TCP et NVMe/FC n'est pas activée par défaut. Le paramètre avancé /Scsi/NvmeUseDsmTp4040 vaut 0, et l'espace libéré sur un datastore VMFS6 NVMe ne revient pas à la baie. vCenter ne lève aucune alerte ; on s'en rend compte en voyant la courbe du pool monter sans jamais redescendre. Broadcom documente le correctif :
bash
esxcfg-advcfg -g /Scsi/NvmeUseDsmTp4040
esxcfg-advcfg -s 1 /Scsi/NvmeUseDsmTp4040
esxcli storage core claiming reclaim -d <namespace_uuid>
Le réglage s'applique aux nouveaux datastores. Pour les datastores existants, il faut relancer le claiming du namespace avec la troisième commande, ou redémarrer l'hôte. À partir de vSphere 9, l'option est active par défaut. Si vous avez migré vers du NVMe/TCP sous 8.0 U2 ou U3, c'est la première chose que je vérifierais.
Quand le pool se remplit
Surallouer ne pose aucun problème tant que le pool a de la marge. Le risque arrive quand elle disparaît, et il vaut mieux savoir comment chaque couche réagit.
La plupart des baies permettent de poser un seuil d'alerte sur le pool ou sur le volume. Une fois ce seuil franchi, la baie renvoie à l'hôte une Unit Attention avec le code 38/07, qui signale que le seuil souple du thin provisioning est atteint. ESXi le remonte en avertissement dans vCenter et le trace dans vobd.log. Les VM tournent toujours. C'est le moment d'agir : ajouter de la capacité ou déplacer des volumes.
Si le pool sature, la baie refuse les écritures qui demandent de nouveaux blocs. Elle répond DATA PROTECT avec le code 27/07 : l'allocation d'espace a échoué et le volume passe en protection en écriture. Dans vmkernel.log, on voit défiler des écritures en échec avec le sense 0x7 0x27 0x7. Côté vSphere, les VM qui ont besoin de nouveaux blocs se figent, et le datastore peut basculer en métadonnées en lecture seule si VMFS n'arrive plus à écrire son journal. Au bout d'un moment, hostd sature sous les erreurs et l'hôte se déconnecte de vCenter.
Ce qui surprend, c'est le décalage entre les couches. Le datastore peut afficher 30 % d'espace libre dans vCenter au moment où la baie refuse les écritures, parce que la saturation se joue dans le pool physique partagé par tous les volumes. Un volume qui grossit vite, une grosse restauration ou une série de clones suffit à remplir le pool et à bloquer des datastores qui n'ont rien à voir avec la cause.
La sortie de crise se fait sur la baie. On libère ou on ajoute de la capacité dans le pool, puis on relance les VM figées. Supprimer des fichiers dans un datastore ne sert à rien tant que la baie n'a pas traité les UNMAP correspondants, et avec le paramètre NVMe évoqué plus haut à 0, elle ne les traitera jamais.
Au quotidien
Le thin provisioning déplace la question de la capacité. On ne dimensionne plus sur la somme des volumes mais sur ce qui est vraiment écrit, et ça dépend des écritures, des suppressions et de la remontée des UNMAP jusqu'au bout de la chaîne. Sur une baie en thin, la pente du pool devient mon premier indicateur de capacité, bien avant la taille des volumes.
Dans les faits, je fixe le seuil d'alerte du pool assez bas pour avoir le temps de commander des disques, pas juste de réagir. Je vérifie que les UNMAP remontent de l'OS invité jusqu'à la baie, granularité comprise, et sur NVMe-oF je contrôle le paramètre DSM de chaque hôte. Pour le reste, je garde la surallocation à un seul étage : je n'ai pas envie de chercher la capacité réelle dans deux consoles.
Une baie de 50 To qui présente 120 To reste une configuration saine. Ce que je surveille, c'est le nombre de semaines qu'il me reste avant que les hôtes écrivent tout ce qu'on leur a promis.